La qualité des données de l'IA compte plus que leur volume. Il y a une idée reçue concernant l'IA : plus on lui fournit de données, plus elle s'améliore. Cela semble logique. Ce n'est pas tout à fait vrai.
Plus n'est pas synonyme de mieux
Voyez cela comme l'apprentissage à partir de notes. Un millier de pages de notes brouillonnes ne vous apprendront pas autant que cinquante pages claires et précises. L'intelligence artificielle apprend de la même manière. Donnez à un modèle une énorme pile d'informations incohérentes et mal étiquetées, et il ne devient pas plus intelligent. Il devient confus. Il commence à capter du bruit au lieu de vrais schémas.
C'est l'une des plus grandes leçons que l'industrie de l'IA a récemment apprises. Un excellent modèle alimenté avec de mauvaises données produit toujours de mauvais résultats. Un modèle simple alimenté avec d'excellentes données peut le surpasser.
Pourquoi cela compte encore plus en médecine
Dans la plupart des secteurs, une mauvaise prédiction de l'IA n'est qu'un inconvénient. Dans les applications médicales et esthétiques, les enjeux sont différents. Un outil de simulation ne doit pas seulement paraître convaincant. Il doit être exact, face à la réalité complexe de vrais patients, de vraies procédures et de vrais résultats.
Cette fiabilité ne vient pas de l'échelle. Elle provient de cas réels et bien documentés : des photos cohérentes, des détails de procédure précis, des comparaisons avant-après honnêtes. C'est le genre de données qui apprend à un système à quoi ressemble un résultat réel, et non pas seulement un résultat propre et idéalisé.
Les équipes l'apprennent généralement à leurs dépens. Des données incohérentes ne se contentent pas de réduire la précision. Elles érodent discrètement la confiance dans l'outil, dans les résultats, et finalement dans la pertinence même d'utiliser l'IA. Un rapport sectoriel récent l'a formulé sans ambages :
“Des données fiables et bien gérées restent le socle de toute innovation future.”
Les cas réels sont difficiles à obtenir. C'est précisément le but
Des données de haute qualité et bien administrées deviennent un véritable atout, et non plus un simple détail technique. Les rassembler exige de la confiance, de la cohérence et de la collaboration. C'est précisément pour cela qu'elles ont de la valeur. Elles ne peuvent pas être extraites par webscraping ou générées à grande échelle.
Imaginez deux outils de simulation par IA. L'un s'entraîne principalement sur des banques d'images et des exemples idéalisés : éclairage soigné, angles parfaits, scénarios optimaux. L'autre s'entraîne sur des cas cliniques réels : éclairage quotidien, morphologies variées, chronologies de guérison réelles, angles parfois imparfaits.
Le premier outil peut paraître plus impressionnant dans une démonstration soignée. Le second a bien plus de chances de viser juste face à un vrai patient, dans une vraie clinique, dans de réelles conditions. Cet écart entre faire bonne figure dans une démo et fonctionner dans la vie réelle est presque toujours une question de données, et non de modèle.
Toute l'industrie évolue vers cette idée
Ce changement va bien au-delà de la médecine esthétique. Dans de nombreux secteurs, les équipes ont passé des années à essayer d'extraire de meilleures performances de leurs modèles. Beaucoup réalisent maintenant que la plus grande opportunité résidait dans leurs données depuis le début. Les régulateurs y prêtent également une plus grande attention. Ils demandent de plus en plus non seulement “ est-ce que l'IA fonctionne ? ”, mais aussi “ pouvez-vous nous montrer d'où viennent les données et qu'elles ont été traitées correctement ? ”
En médecine esthétique, de vrais patients confient leurs données à de vrais médecins. Cela rend la question encore plus importante. Un outil d'IA n'est digne de confiance que dans la mesure du processus qui sous-tend les données sur lesquelles il a été formé, y compris qui a donné son autorisation et avec quelle attention cette autorisation a été respectée.
C'est l'idée derrière quelque chose de nouveau que nous construisons
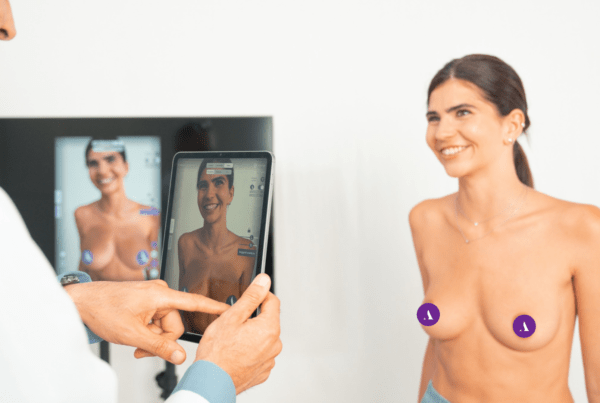
C'est aussi toute la raison d'être d'un nouveau programme que nous lançons chez Arbrea : le Programme de partenariat de recherche Arbrea. Au lieu de courir après plus de données, nous établissons des collaborations directes avec des médecins et des cliniques qui documentent déjà bien les cas réels. Le consentement reste exactement là où il doit être : entre le médecin et son patient, dans le cadre de la pratique normale. Arbrea ne travaille qu'avec des cas anonymisés. L'objectif n'est pas d'obtenir un plus grand ensemble de données. Il s'agit d'en obtenir un meilleur : de vrais cas, issus de cabinets réels, qui rendent nos simulations plus précises pour tout le monde.


 English
 Portuguese
 Italian
 Spanish
 German
 Arabic
 French
 Korean
 Albanian
 Thai
 Hindi