先週、我々は集約データを用いて訓練されたシミュレーションが平均的な結果を予測するという主張をし、外科医が平均的な患者を対象に手術を行うわけではないと論じた。その自然な続報は実用的な問題である。パーソナライゼーションが答えであるなら、実際には何が必要になるのか、そして外科医が自身の症例を共有するときにどのモデルが学習するのかということだ。
この記事は機械的な説明です。ソフトウェアに自分のスタイルを教えることについてのメタファーはありません。その表現は重要な部分を隠しているからです。.
3つの層、1つのモデルではない
それは、固定されたものと適応するものの区別を助ける。.
1層目は物理学です。. 軟組織は外科医特有のものではない機械的特性に従って変形する。Arbreaのシミュレーションコアは、負荷下で変形体を正しく動作させるという課題から生まれた。ここでは組織の弾性、体積移動、重力応答が取り上げられる。この層はカスタマイズする必要はなく、カスタマイズすべきでもない。力学は力学である。.
レイヤー2は一般的なモデルです。. これは、術前のアナトミーと手術の意図を元に、特定の基底幅と組織品質を持つ患者において350ccの適度なサイズのインプラントがどのような結果をもたらすかを、幅広い症例群から学習した、妥当な術後形状の学習マップです。このマップは、その結果を平均として把握しています。.
3層目の機能は適応です。. これは、リサーチパートナープログラムが構築する層です。この層は、1つの実践におけるペアリングされたケースを用いて一般的なマッピングを調整します。つまり、モデルが複数の妥当な結果の間で不確実な場合、そのモデルは実際にその実践が生成する結果に近づきます。.
この違いは重要である。なぜなら、それは現実的な期待を定めているからだ。パーソナライゼーションは数百の症例からシミュレーションをゼロから再構築するわけではない。それは不可能でも安全でもない。むしろ、うまく動作する一般的なモデルを、特定の外科医が担当する結果空間の領域へとシフトさせるだけだ。.
有用なデータとはどういうものか
外科医は、答えは体積であると考える傾向があります。より多くの症例、より良いモデル。体積は役に立ちますが、それだけでは限界を押しとどめることはできません。むしろ、一貫性が重要です。.
4つの要素がケースを有効なものにする。.
ペアでのキャプチャ。. 同じ患者の術前3Dスキャンと術後3Dスキャン。これら2つの画像がなければ、学ぶべきことは何もない。単なる術後写真ではモデルに結果がどう見えるかだけがわかるが、その開始的な解剖学的構造はわからない。つまり、この信号は2つの画像との関係の中で生み出されるものだ。.
手術後の間隔が一定であること。. 6週目の組織と9ヶ月目の組織は異なる組織です。腫れは解消し、インプラントは安定し、下端は弛緩します。間隔が予測不能に変化するデータセットはモデルに、同じ手術でも多くの異なる結果を生み出すことを教えてくれます。これは目標とは正反対です。定義された間隔で一貫して捕捉する手法は、患者がいつ戻ってくるかという偶然に左右されるよりも、1件あたりの収穫がはるかに多いのです。.
この事件に関連する決定事項。. インプラントメーカー、参考例、量、プロファイル。ポケットおよび平面。外科医が結果に重要視する材料に関する技術的な詳細(例えば、下位部の放出の程度または折り目の管理)。これらのラベルがなければ、モデルは入力と出力の双方を考慮した上で、その理由を排除し、インプラントの効果と技術の効果を分離することができない。.
ドリフトしない状態をキャプチャする。. 同じデバイス、同じ患者の位置、同じ腕の位置。これは面倒な話のように聞こえる。しかし、これは手術の学習モデルと、ある特定の日にある特定の部屋がどのように配置されていたかという固有の特性を学習するモデルの違いだ。.
1人の外科医によって撮影された、ラベルがしっかり付けられていて一貫して記録されたカップルの数は、その数を数倍に増やすこともなく、より適応性の高い信号を伝えてくれます。これはほとんどのパートナーにとって驚きとなる部分です。.
モデルが学習しないこと
一般に懸念される点であるため、明言しておく価値があります。.
このモデルは患者の特定を学習していない。適応は身体構造や手術パラメータに基づいているが、身元を特定するものではない。患者データは学習プロセスに入る前に匿名化され、研究利用の同意はパートナーの独自の患者同意ワークフローを通じて取得される。.
パートナーが受け取るもの
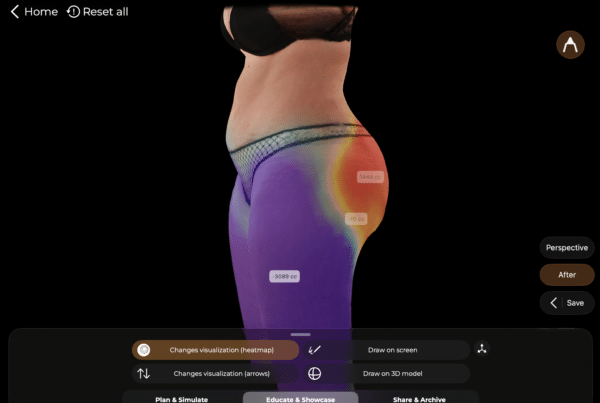
参加による出力は、その実践に合わせてシミュレーションが調整されたバージョンのArbreaです。具体的には、このモデルは実際に外科医が使用するポケットに沿って解像し、実際に在庫しているインプラントファミリーを重み付け、実際に治療する患者の組織挙動を反映します。.
2つの副効果は、1つ目の効果ほど重要である傾向があります。.
まず第一に、データセットの構築は、自身の結果の記録を標準化する実践を強制する。このプロセスを完了した外科医は、モデルに関わらず、これまで保有してきた自身の結果に関する最初の体系的な縦断的な記録を通常手にしている。複数のパートナーはこれをより即座に有用な結果だと述べている。.
2つ目の手法は、反対の方向での校正です。外科医が自身の集計結果を一般的なモデルと比較すると、その違いは技術の評価ではなく、その技術の評価にすぎません。.
この取り組みの正直なバージョンは以下の通りです。
これは被動的なプログラムではありません。貢献とは、プロトコルに基づいたスキャンを収集し、技術の詳細を記載したケースラベルを付け、患者を定義された術後間隔まで追跡することです。すでに定期的にスキャンを行っている診療所にとって、この追加作業はわずかなものです。そうでない場合は、ワークフローの変更となります。.
この取引は明白だ。その構造化された努力をした外科医たちは、自分たちの仕事に合わせたモデルを手に入れる。そして、そのモデルはまだ全員の仕事に合わせたモデルを使っていて、その分野がそのモデルをそのまま使い続けている間に、先にそのモデルを手に入れることになる。.


 English
 Portuguese
 Italian
 Spanish
 German
 Arabic
 French
 Korean
 Albanian
 Thai
 Hindi
 Vietnamese
 Japanese