पिछले सप्ताह हमने तर्क दिया था कि समेकित डेटा पर प्रशिक्षित सिमुलेशन एक औसत परिणाम की भविष्यवाणी करता है, और यह कि कोई भी सर्जन औसत दर्जे का काम नहीं करता। स्वाभाविक रूप से उठने वाला सवाल व्यावहारिक है। यदि व्यक्तिगत अनुकूलन ही उत्तर है, तो वास्तव में इसके लिए क्या आवश्यकता होती है और जब एक सर्जन अपने मरीज़ों के मामले साझा करता है, तब एक मॉडल क्या सीखता है?
यह लेख एक यांत्रिक व्याख्या है। सॉफ्टवेयर को अपनी शैली सिखाने के बारे में कोई भी रूपक न डालें, क्योंकि ऐसा कहने से वह बात जो महत्वपूर्ण है, उसे छिपा दिया जाता है।.
तीन परतें, एक ही मॉडल नहीं
इससे जो कुछ स्थिर रहता है, उसे अलग करने में मदद मिलती है, वही जो अनुकूल होता है।.
पहला परत भौतिकी है।. नरम ऊतक उस यांत्रिक गुणों के अनुसार विकृत होता है जो किसी भी सर्जन के लिए विशिष्ट नहीं होते। अरब्रेया का सिमुलेशन कोर ईटीएच ज़्यूरिख के शोध से निकला है, जहाँ समस्या यह थी कि ढीली हो सकने वाली संरचनाओं को भार के तहत सही ढंग से व्यवहार कराना चाहिए। यहाँ ऊतक की लोच, मात्रा में बदलाव और गुरुत्वाकर्षण प्रतिक्रिया शामिल हैं। इस परत को अनुकूलित करने की आवश्यकता नहीं है और इसे अनुकूलित भी नहीं किया जाना चाहिए। यांत्रिकी ही यांत्रिकी है।.
लेयर दो सामान्य मॉडल है।. यह पूर्व-शल्यक्रियात्मक आनुवंशिकी और शल्यक्रिया के उद्देश्य से निर्मित एक विश्वसनीय पोस्ट-शल्यक्रियात्मक आकार के बीच की सीखपूर्ण समझ है, जो व्यापक रोगी आबादी पर आधारित है। यह यह जानता है कि किसी दिए गए आधार चौड़ाई और ऊतक गुणवत्ता वाले मरीज़ में 350 सीसी मध्यम-से-अधिकतम आकार का इम्प्लांट कैसा व्यवहार करता है। यह यह औसत मान से जानता है।.
तीसरा स्तर अनुकूलन है।. यह वह परत है जो रिसर्च पार्टनर प्रोग्राम बनाता है। यह एक ही अभ्यास के जोड़े हुए मामलों का उपयोग करके सामान्य मानचित्रण को समायोजित करता है, ताकि जब मॉडल में कई संभावित परिणामों के बीच अनिश्चितता हो, तो वह उस परिणाम की ओर जाता है जो वास्तव में अभ्यास में मिलता है।.
यह अंतर महत्वपूर्ण है क्योंकि यह एक यथार्थवादी अपेक्षा स्थापित करता है। व्यक्तिगतकरण कुछ सौ मामलों पर सिमुलेशन को बिल्कुल नए सिरे से नहीं बनाता है, जो न तो संभव है और न ही सुरक्षित। यह एक अच्छी तरह से व्यवहार्य सामान्य मॉडल को उस परिणाम क्षेत्र में ले जाता है जहाँ एक विशिष्ट सर्जन काम करता है।.
उपयोगी डेटा किसे माना जाता है
सर्जन आमतौर पर यह मानते हैं कि जवाब मात्रा है। ज़्यादा मामले, बेहतर मॉडल। मात्रा मददगार होती है, लेकिन यह बाध्यकारी बाधा नहीं है। स्थिरता ही है।.
चार चीजें एक मामले को उपयोगी बनाती हैं।.
एक युग्मित कब्जा।. एक पूर्व-सर्जिकल 3डी स्कैन और एक पश्चात-सर्जिकल 3डी स्कैन एक ही मरीज के। इन दोनों के बिना, कुछ भी सीखने के लिए कोई आधार नहीं होता। एक पश्चात-सर्जिकल तस्वीर से ही मॉडल को यह पता चल जाता है कि परिणाम कैसा था, लेकिन यह नहीं कि शुरुआती शारीरिक संरचना कैसी थी; और यह सारी जानकारी इन दोनों के बीच के संबंध में निहित है।.
एक निरंतर पोस्ट-ऑपरेटिव अंतराल।. छह सप्ताह के बाद की ऊतक और नौ महीने के बाद की ऊतक अलग-अलग ऊतक होते हैं। सूजन कम हो जाती है, प्रत्यारोपण ठीक हो जाता है, निचली धड़ की मांसपेशी आराम पाती है। एक ऐसी डेटासेट जिसमें अंतराल अनिश्चित रूप से बदलता रहता है, यह मॉडल को सिखाती है कि एक ही सर्जरी से कई अलग-अलग परिणाम मिलते हैं, जो लक्ष्य के विपरीत है। एक ऐसी पद्धति जो लगातार एक निश्चित अंतराल पर परिणाम दर्ज करती है, प्रति मामला उससे कहीं अधिक योगदान देती है, जो ऐसी पद्धति से है जिसमें हर बार ही मरीज वापस आता है।.
मामले से जुड़ी हुई निर्णयियाँ।. इम्प्लांट निर्माता, संदर्भ, मात्रा और प्रोफाइल। पॉकेट और प्लेन। सर्जन द्वारा परिणाम के लिए सामग्री के रूप में माना जाने वाले किसी भी तकनीक संबंधी विवरण, जैसे कि निचले हिस्से में ढीलीपन की सीमा या फोल्ड प्रबंधन। इन लेबलों के बिना, मॉडल को एक इनपुट और एक आउटपुट मिलता है, जिसमें तर्क हटा दिया जाता है, और यह नहीं जान पाता कि इम्प्लांट का प्रभाव तकनीक के प्रभाव से अलग है या नहीं।.
ऐसे स्थितियाँ कैप्चर करें जो विचलित न हों।. एक ही डिवाइस, तुलनीय रोगी की स्थिति, तुलनीय भुजा की स्थिति। यह थोड़ा दकियानूसी लगता है। यह वह अंतर है जो सर्जरी सीखने वाले मॉडल और उस विशेष दिन किसी विशेष कमरे की स्थापना के विशिष्ट पहलुओं को सीखने वाले मॉडल के बीच होता है।.
एक ही सर्जन द्वारा खींचे गए, अच्छी तरह से लेबलित और लगातार एक-दूसरे के साथ जुड़ी सैकड़ों जोड़े, ढीले ढंग से खींचे गए कई गुना अधिक अनुकूलनशील संकेत देते हैं। यह वह हिस्सा है जो अधिकांश भागीदारों को आश्चर्यचकित करता है।.
मॉडल क्या नहीं सीखता
इसका स्पष्ट रूप से उल्लेख करना ज़रूरी है, क्योंकि यह एक आम चिंता है।.
मॉडल मरीजों की पहचान करना नहीं सीख रहा है। अनुकूलन आनुवंशिक ज्यामिति और सर्जिकल मापदंडों पर आधारित है, न कि पहचान पर। किसी भी प्रशिक्षण प्रक्रिया में प्रवेश करने से पहले रोगी के डेटा को पहचान से अलग कर दिया जाता है, और शोध उपयोग के लिए सहमति उस साथी के अपने रोगी सहमति वर्कफ़्लो के माध्यम से प्राप्त की जाती है।.
एक साथी को क्या मिलता है
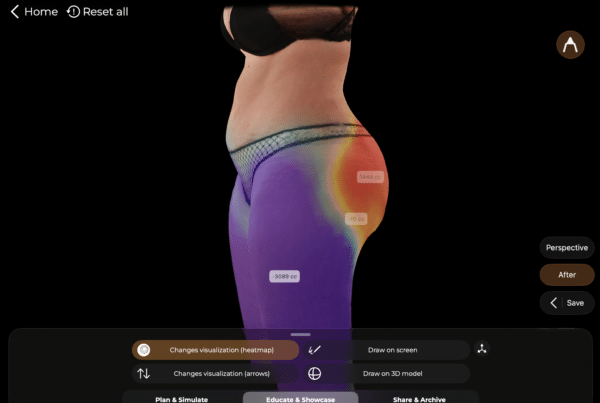
भागीदारी के परिणाम में Arbrea का एक संस्करण है, जिसका सिमुलेशन उस व्यवहार के अनुरूप कस्टमाइज़ किया गया है। वास्तव में, इसका मतलब है कि यह मॉडल सर्जन द्वारा वास्तव में उपयोग किए जाने वाले जेब के आकार को ध्यान में रखता है, वास्तव में उपलब्ध इम्प्लांट परिवारों का भारवज़न करता है, और उन लोगों के ऊतक व्यवहार को दर्शाता है जिन्हें वे वास्तव में इलाज करते हैं।.
दो माध्यमिक प्रभाव प्राथमिक प्रभाव जितना महत्वपूर्ण होते हैं।.
पहला यह है कि डेटासेट का निर्माण करने से अपने परिणामों को मानक बनाने के लिए एक प्रक्रिया को लागू करना पड़ता है। जिन सर्जन ने इस प्रक्रिया को पूरा किया है, वे आमतौर पर इस मॉडल से स्वतंत्र अपने परिणामों का पहला व्यवस्थित अनुदैर्ध्य रिकॉर्ड तैयार करते हैं। कई साथी इस प्रक्रिया को अधिक तुरंत उपयोगी परिणाम बताते हैं।.
दूसरा तरीका दूसरे दिशा में अंशांकन है। जब एक सर्जन अपने एकत्रित परिणामों की तुलना सामान्य मॉडल से करता है, तो यह अंतर उनकी तकनीक का एक माप होता है, न कि उस पर कोई धारणा।.
इस प्रयास के ईमानदार संस्करण में शामिल थे
यह कोई निष्क्रिय कार्यक्रम नहीं है। योगदान का अर्थ है एक प्रोटोकॉल के अनुसार स्कैन लेना, तकनीक के विवरण के साथ मामलों को लेबल करना, और मरीज़ों का निर्धारित पोस्ट-ऑपरेटिव अंतराल तक फॉलोअप करना। जिन मरीज़ों को नियमित रूप से स्कैन किया जाता है, उनके लिए अतिरिक्त कार्य मामूली है। जिन मरीज़ों को ऐसा नहीं करते हैं, उनके लिए कार्यप्रणाली में बदलाव होता है।.
व्यापार स्पष्ट है। जो सर्जन इस तरह के प्रयास करते हैं, उन्हें अपने काम के अनुरूप एक मॉडल मिलता है, और वे पहले इसका उपयोग करते हैं, जबकि तब तक क्षेत्र उन मॉडलों का उपयोग करता है जो सभी के काम के अनुरूप बनाए गए हैं।.


 English
 Portuguese
 Italian
 Spanish
 German
 Arabic
 French
 Korean
 Albanian
 Thai
 Hindi
 Vietnamese
 Japanese